

数据进入
加载并整合数据
接入数据库、电子表格、文档集合、邮件及Web等来源,并将文本与相关结构化字段连接起来。

PolyAnalyst for Text 面向多语言文档及文本数据分析,可将文本与结构化字段放在同一分析流程中,完成信息提取、文档组织、情绪分析和结果表达。可视化工作区用于组合数据加载、清理、语言处理、分析与报告步骤。
软件将数据进入、内容整理、文本分析和结果交付放在连续流程中。每个环节可以按数据来源、语言和项目目标组合,并保存为可复用的分析方案。
数据进入
接入数据库、电子表格、文档集合、邮件及Web等来源,并将文本与相关结构化字段连接起来。
内容准备
利用数据清理、拼写纠正、词典管理和转换工具整理分析前的数据与文本。
文本理解
组合语言、语义、统计和机器学习方法,识别实体、事实、关系、主题和情绪。
结果交付
使用图表、表格、网络视图和报告汇总结果,并按项目需要保存或发布分析输出。

文本分析不仅依赖关键词匹配。软件将语言结构、领域语义及数据驱动方法组合起来,用于从文档中识别目标信息并形成可检查的分析结果。
提供词汇、形态和句法分析,并支持语言检测、词性标注、关键词和短语提取等任务。
可结合本体、语义词典、同义关系和领域词典,让查询、实体识别和分类规则贴合业务语境。
用于文档分类、聚类、相似文档发现、情绪分析及从预分类样本训练分类模型。
项目可以从一个明确问题出发选择能力组合,不必将所有分析方法同时加入流程。
从文档中识别人名、组织、产品、事件或其他领域对象,并提取对象之间的关系和所需事实。
按既定分类体系自动组织文档,也可在缺少预设类别时通过聚类探索文档集合中的主题结构。
提取关键词和短语,生成文档摘要,并结合语义关系扩展查询与内容查找。
识别文本中的情绪信息,把提取出的主题、实体和关系转为可与其他属性共同分析的字段。
支持包括中文在内的多语言原生文本分析,可在原语言内容上执行相应语言处理。
语言包覆盖英语、中文、日语、韩语、阿拉伯语及多种欧洲语言。实际项目还可结合领域词典和分类体系;选型时应按目标语种、术语体系、文档类型和需要抽取的对象核对配置。
产品界面可将词项、原文片段、关系网络及图表放在分析结果中查看。以下图示分别展示文本关系分析、Web报告和网络结果。


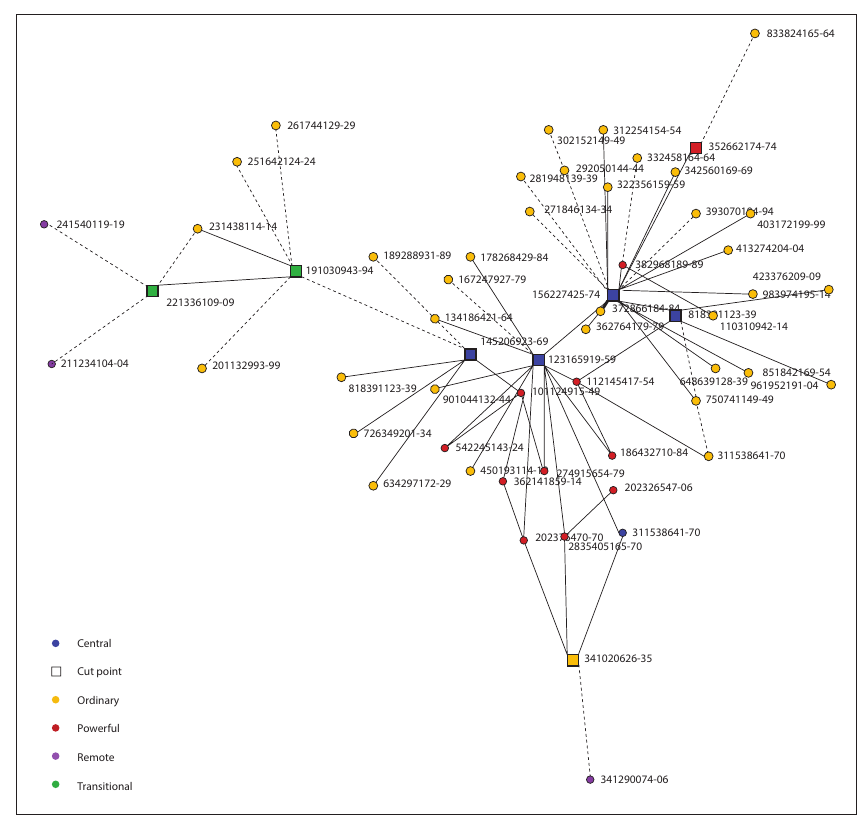
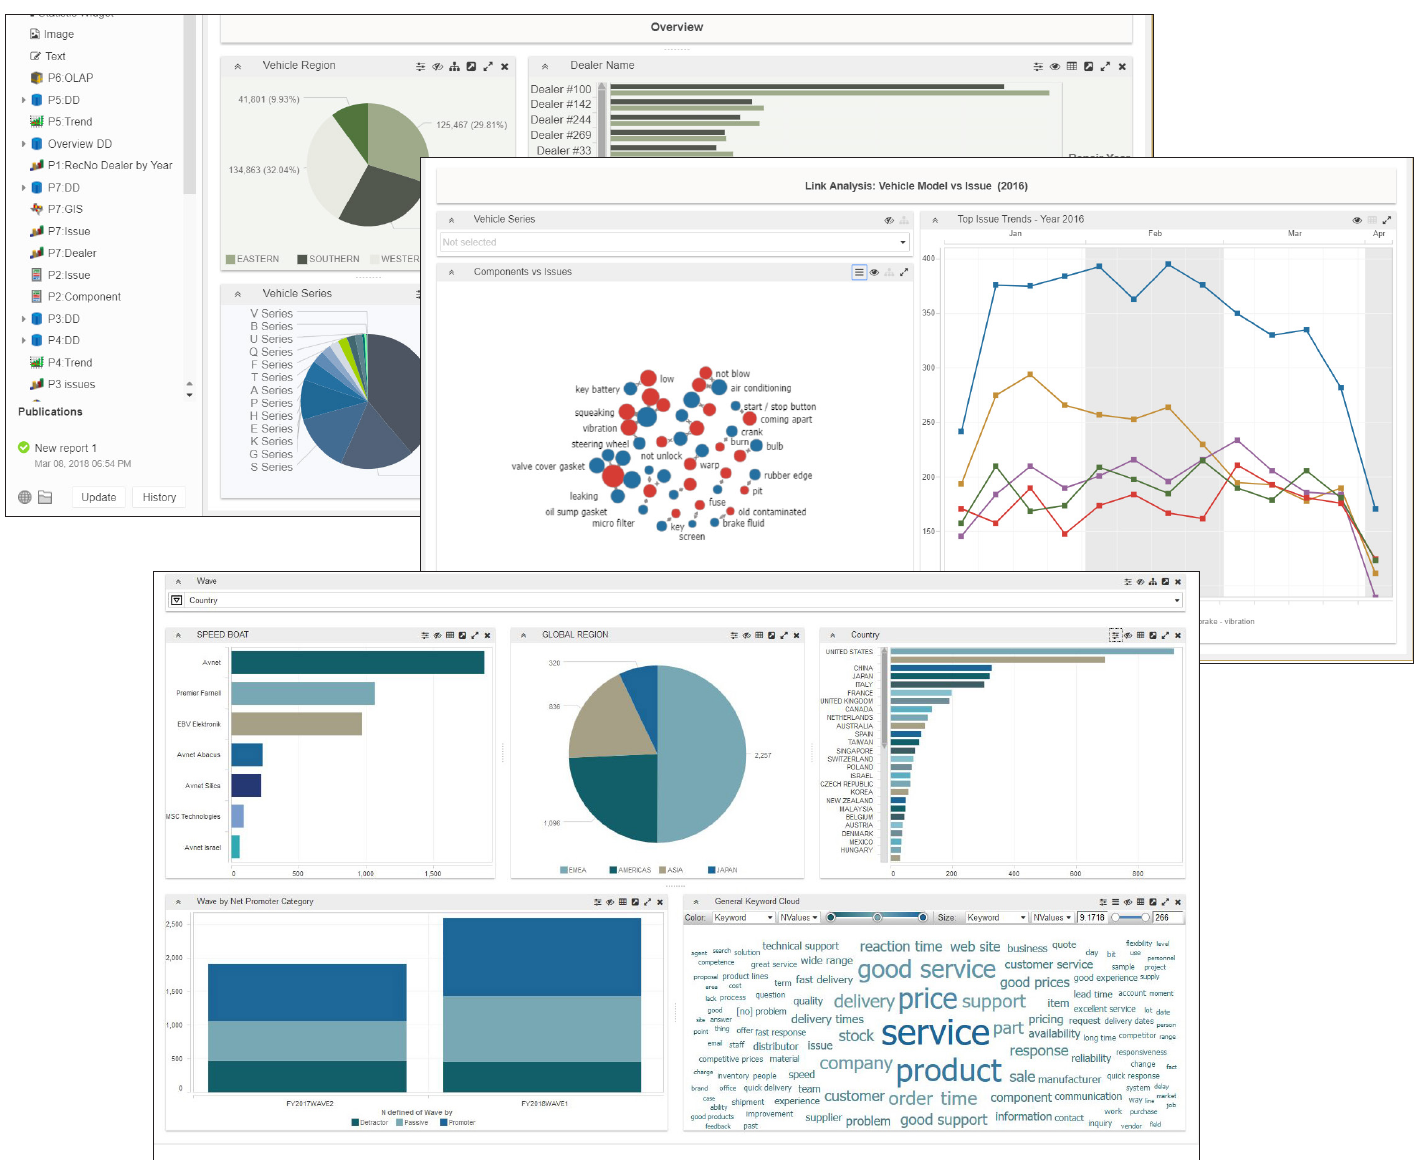
应用方向应由数据来源、目标语言、分类体系和最终输出决定。
对调查问卷、评论、客服记录或工单文本进行主题组织、编码和情绪分析。
从文献集合中提取术语、实体和关系,辅助整理研究主题及相关对象。
对新闻、网页和其他文本来源进行分类、事实提取与关系整理。
结合领域词典处理索赔说明、医疗记录或其他专业文本中的目标信息。
PolyAnalyst 产品体系包含面向不同任务的方向。采购前应区分文本分析、预测建模、报告分发和分布式处理需求。
本页重点
用于多语言文本分析,覆盖事实与关系提取、分类、聚类、摘要和情绪分析,并可结合结构化字段建立文本分析流程。
适合还需要结构化数据预测建模、异常检测或更广泛机器学习分析的项目。
用于通过浏览器向非技术用户提供可交互的分析结果和图形报告。
面向需要在分布式环境中处理较大文本与数据工作负载的方向。
可结合项目数据申请试用或演示,再按语言、文档类型、分析任务和交付方式确认产品组合与报价。
确认数据来源、文档格式、目标语种、数据规模及文本与结构化字段的关联方式。
明确需要提取的实体、事实、关系、分类体系,以及是否需要领域词典或定制规则。
核对用户角色、流程调度、报告受众,以及是否需要Web报告或分布式处理方向。